

具身智能,正在探索如何将理解世界的能力,转化为机器人在物理世界中的行动。视觉语言动作模型(VLA)将视觉观测、语言指令与动作生成连接起来;世界动作联合建模则把动作及其预期引起的状态变化纳入同一生成过程,让操作决策能够同时考虑“怎么做”与“做了之后会怎样”。
面向长期服务家庭的目标,未来不远进一步关注能力如何持续增长。衣物的形态、工具的接触、任务的进度都在变化,机器人需要应对不同的操作情况,处理预测与现实之间的偏差。这些经历,如何成为下一次进步的依据?
我们希望建立一条能够持续验证自身效果的学习路径:机器人从真实执行中获得经验,模型通过这些经验更新;训练完成后,系统进一步检验不同经验选择与训练配方组合的实际收益,并据此调整后续学习。
一次训练留下的,既有更新后的模型,也有下一轮怎样学习的依据。
为此,未来不远发布 Self-Evolving WAM 自进化世界动作模型,将世界动作联合建模、交互经验学习与训练效果反馈接入同一套系统:执行时,联合生成动作及其预期后果;执行后,将决策记录与真实结果对齐;更新模型后,再根据评测结果,在预设范围内调整经验选择与训练配方。

( Self-Evolving WAM 总体架构 )
在实际记录的第 0 轮至第 30 轮更新尝试中,四组家庭任务的自主完整成功率均有提升:叠衣服从 54.6% 提升至 96.8%,晾衣服从 46.2% 提升至 91.2%,做意面从 42.7% 提升至 89.5%,辣椒炒肉从 38.2% 提升至 68.9%。
从真实执行中学习,再用训练效果改进后续学习。这是我们通过 Self-Evolving WAM 探索的能力增长路径。

我们选择叠衣服、晾衣服、做意面和辣椒炒肉,观察模型在柔性物体、接触对位、工具使用和多步骤任务中的表现。评测以一项任务从头到尾自主完成为标准:人工接管后完成不计入自主成功,超时与失败保留在统计之中。

( 四组家庭任务在不同更新尝试轮次下的自主完整成功率 )
01 叠衣服
每一次折叠,都在改变下一次抓取的条件。
衣物被提起、铺开,再沿边角折叠。双臂需要根据衣物的新形态,衔接抓取、移动与释放。前一步的偏差,还可能影响后续边角对齐。我们在完整流程中检验抓持、折叠与形态保持能否相互衔接。
02 晾衣服
支撑关系的转换,决定何时可以释放。
衣物从双臂抓持转为衣架承托,再挂到横杆上。衣架是否穿入到位、衣物是否得到承托、挂钩是否与横杆对准,决定了下一步动作能否继续。这一任务将精细对位与双臂协同放在连续的状态转换中检验。
03 做意面
双臂的配合,要落实为食物的正确转移。
面食转移、加入配料、搅拌与装盘,需要在前一环节完成后顺畅衔接。倾锅装盘时,一只手调整锅具姿态,另一只手用锅铲辅助转移;动作是否奏效,要看食物实际落在哪里。
04 辣椒炒肉
重复操作中,还要判断何时进入下一阶段。
连续切分时,局部动作相似,剩余食材和已处理区域却不断变化。机器人需要结合对象状态与操作历史判断阶段进度,从切分转向转移、添料和翻炒。我们用这类任务检验重复操作中的阶段判断与衔接。
四组任务把动作与结果之间的联系具体地呈现出来:衣物有没有对齐、支撑是否到位、食物是否转移、当前阶段是否完成。这些执行结果,也构成后续学习所需的真实经验。
一段经验看起来值得学,是否真的能带来改进,需要经过训练与评测检验。
预测误差较大,可能意味着模型遇到了尚未掌握的状态,也可能来自观测噪声或执行干预。同类成功样本在能力形成阶段提供示范,充分学习后,它们的新增价值也会变化。为家庭机器人建设持续学习能力,需要让经验的选择跟上模型能力的变化。
我们通过经验选择器Evolution Judge,在具备有效监督的记录中,综合预测误差、任务覆盖、候选差异与重复程度,安排样本优先级。Training Agent再将选定经验组织为训练批次,在预定义的有限配方中,调整各类经验的采样比例,以及世界预测、动作学习的训练权重。
这套选择是否合适,由训练后的实际表现回答。
我们让不同的经验选择与训练配方组合,从同一个模型、同一份经验池出发,在匹配的训练预算下分别更新,再通过统一开发评测比较。评估既看任务能否完成,也看风险、旧任务能力保持和部署成本。
例如,提高一类经验的采样比例后,即使当前任务表现变好,也需要检查已有能力是否退化、风险是否满足要求。系统将这些结果记录为该组选择方式与训练配方的效果,为后续配置的评估优先级和资源分配提供依据。
只有满足改进与验收条件,学习配置才会变更;相应模型还要通过版本验收,才能接替运行版本。证据不足或未通过验收时,系统保留原有配置或模型。
真实执行为模型提供学习经验,训练效果为后续学习提供调整依据。Self-Evolving WAM 将这两层反馈连接起来,让模型更新和学习方式的调整,都能接受实际结果的检验。

( 训练效果反馈 )
上述学习过程,需要能够说明“采取了什么动作、产生了什么结果”的经验。为此,我们在执行阶段就建立动作与预期后果的对应,并将真实反馈保留下来。
动作与未来,在同一个生成过程中相互约束。
衣角从哪里提起,会影响衣物如何展开;锅具往哪个方向倾斜,会影响食物如何转移。Self-Evolving WAM 在共享主干中联合生成未来状态与机器人动作,视频和动作表示通过共享注意力、联合去噪交换信息。每组候选都包含一段动作,以及与之对应的预期状态变化。
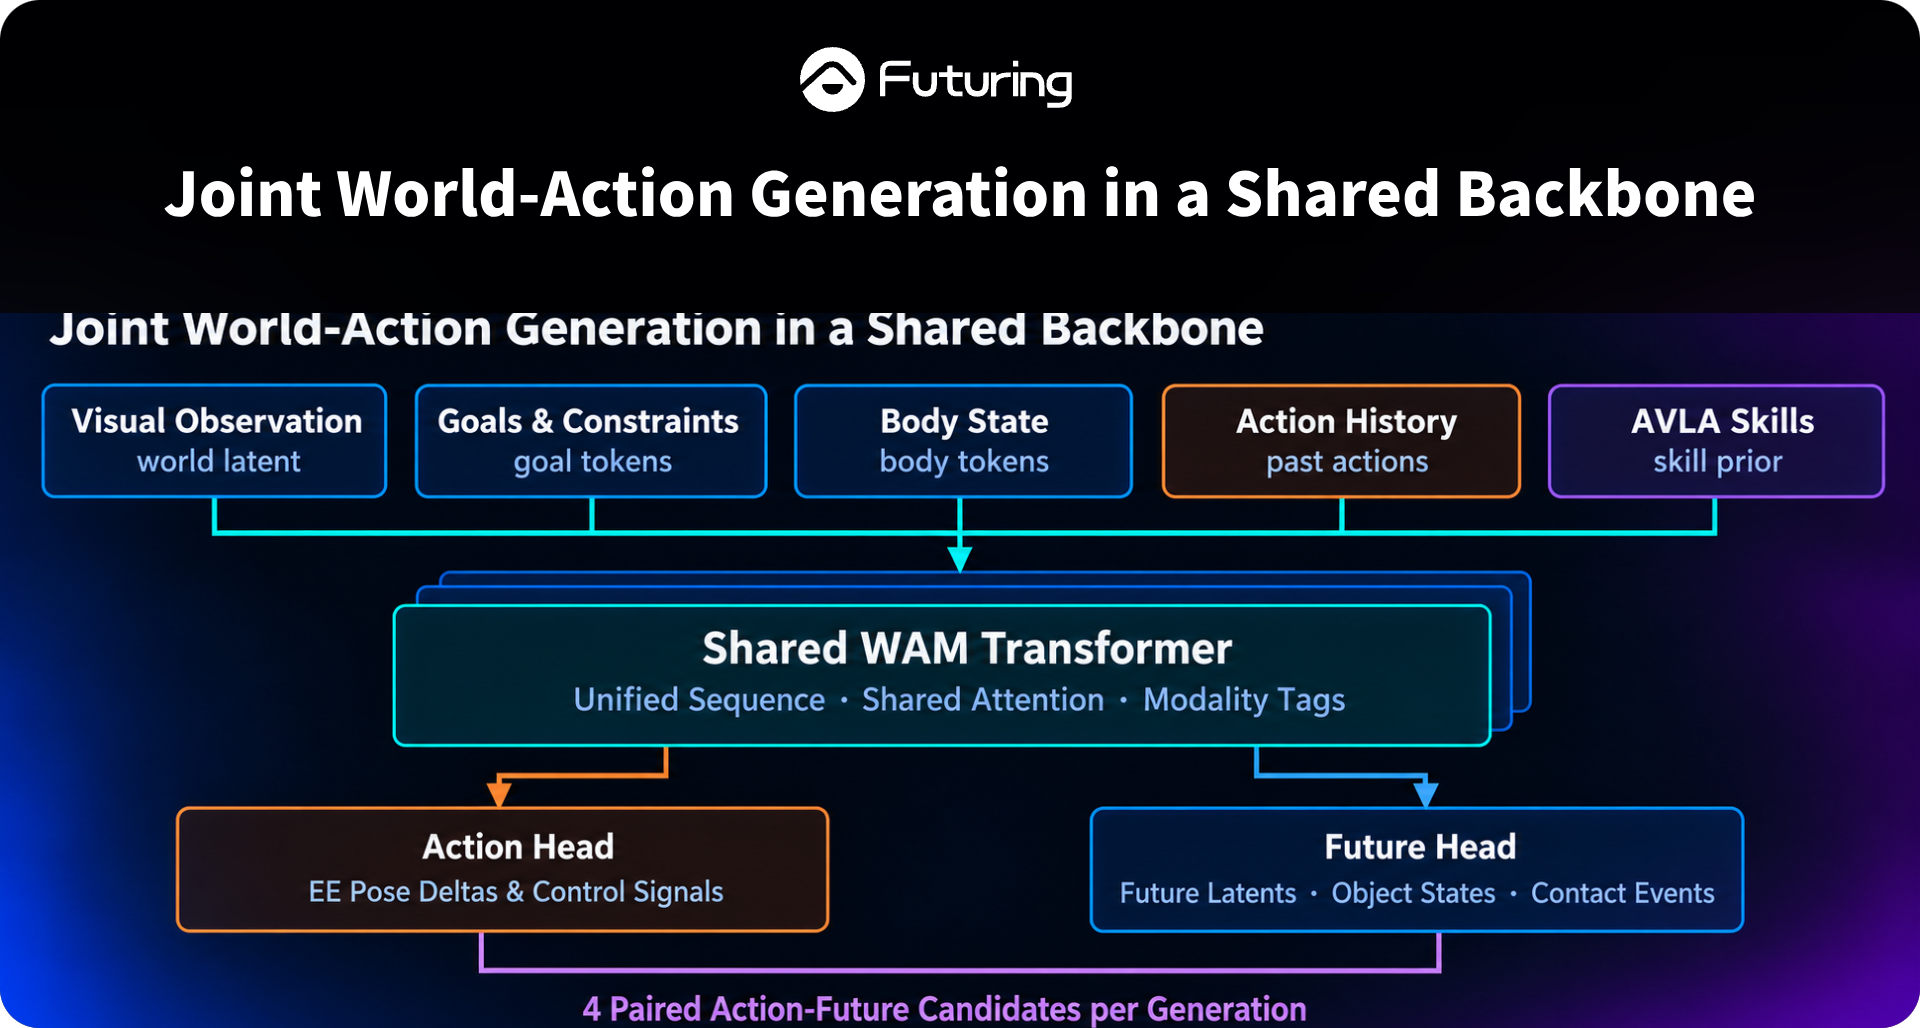
( 动作与预期未来在共享主干中联合生成 )
这套能力以1万小时自有第一人称视频和3万小时 Futuring Robot F1/F2 交互数据为训练基础。第一人称视频提供操作过程中的视觉时序经验,机器人交互数据则将观测、本体状态、动作与执行结果联系起来。
每次决策,系统生成多组配对候选,经本体约束检查、独立评价器的风险评估与效用排序,选出执行方案。机器人先执行选中序列的一小段,系统同时结合新观测规划后续动作,使计划能够随实际变化及时调整。
一次操作留下的经验,包含预测、选择和真实结果。
我们通过 Stored-K 保存候选动作、预测未来、事前评价与实际选择,再将执行记录、后续观测及干预情况关联起来。在实际执行且观测有效的窗口内,预测与真实变化才有可比较的依据。
例如,控制器在执行时实质修正了动作,这段结果就需要按修正后的真实动作理解。Stored-K 保留相应记录,避免把执行变化全部归因于原候选的预测错误。
不同证据也承担不同的学习用途:经验证的成功动作与有效纠正用于动作学习,失败片段中的真实状态变化用于世界预测,失败与险情还用于独立评价器的风险和失败学习。尚未执行的候选保留为独立检查或复验线索,其结果需要相应证据确认。
从动作与未来的联合生成,到执行反馈的有效对齐,再到训 练效果对后续学习的调整,我们让一次交互的价值能够沿着这条路径进入模型更新。
四组任务的迭代结果,是我们对这条技术路径的阶段性验证。此外,模型也具备一定的零样本泛化与单次示范适应(one-shot)能力,能在未见场景中做出合理推演,并在单次演示后快速适配新任务。面向更多物体、布局与操作条件,我们还需要进一步检验经验的适用范围,以及不同机制对能力提升的贡献。
Self-Evolving WAM 也将部署于未来不远即将发布的第三代机器人,推动自进化能力在千元级成本的机器人平台上落地。
接下来,未来不远将继续完善经验价值估计,探索跨任务的学习反馈共享,并降低世界动作推理的计算成本。让哪些经验值得学、怎样训练更有效、这套机制如何持续运行,都得到更充分的验证。
让过去的操作成为下一次行动的依据,让每轮训练的得失成为下一轮学习的依据。 我们将沿着这条路径,持续建设家庭机器人可靠操作与长期学习的能力。
 热点新闻